生成モデルで形状を作る — VAE・GAN・拡散モデルを整理する
はじめに
CFDの形状最適化では、翼型ならキャンバーや翼厚、流路なら断面積比や曲率半径といった数個〜数十個のパラメータで形状を表すのが一般的です。
ただしパラメトリック表現には天井があります。 パラメータ数を絞るほど扱いやすくなりますが、表現できる形状のバリエーションも狭くなります。 逆に自由度を上げると、今度は「もっともらしい形状」を保つのが難しくなり、製造不可能だったり流体力学的に意味のない形状ができやすくなります。
生成モデルは、既存の設計データという「もっともらしい形状の集合」から共通する構造を低次元の潜在空間として学習し、パラメトリック表現よりずっと広いバリエーションを、少ない自由度のまま扱えるようにします。
今回はVAE・GAN・拡散モデルという3つの生成モデルを順に整理し、最後にこれらを最適化にどう組み込むかを考えます。
潜在空間を学習する — VAE
VAE(Variational Autoencoder)は、エンコーダで形状 を潜在変数 に写し、デコーダで から を再構成するように学習するモデルです。 目的関数は次のELBO(証拠下限)で、第1項が再構成誤差、第2項が潜在変数の分布 を事前分布 (通常は標準正規分布)に近づける正則化です。
この正則化により、潜在空間には「近くの点は近い形状に対応する」という滑らかな構造ができやすくなります(KL項が直接保証するわけではなく、経験的に観測される傾向です)。
弱点は生成される形状がぼやけやすいことです。 再構成誤差を画素・ボクセル単位、あるいは点列の座標単位で平均評価するため、細かい凹凸やエッジが平均化されて丸まってしまいます。
敵対的学習で鮮明さを取り戻す — GAN
GAN(Generative Adversarial Network)は、潜在変数 から形状を作るGeneratorと、それが本物か生成物かを見分けるDiscriminatorを敵対的に学習させるモデルです。
Generatorは Discriminator を騙せるように、Discriminatorは騙されないように競わせながら学習を進め、再構成誤差の平均化を経由しないぶん、VAEより鮮明でリアルな形状が生成される傾向があります。
一方でこの方式は学習が不安定になりやすく、Generatorが限られた種類の形状ばかり出力するモード崩壊が典型的な失敗です。 潜在空間の滑らかさもVAEほど保証されず、ELBOのような正則化項がないぶん、 を少し動かしただけで形状が大きく飛ぶ領域ができやすくなります。
ノイズ除去過程として生成する — 拡散モデル
拡散モデルは、データに少しずつノイズを加えるforward processと、その逆をたどってノイズから形状を復元するreverse processの組で構成されます。 forward processは単純にノイズを加えるだけなので学習は不要で、学習が必要なのはreverse processだけです。
実装上は、各ステップで加わったノイズ をモデル に予測させる、次の単純な目的関数で学習することが多いです。
GANのような敵対的な最適化がなく、目的関数がノイズ予測という素直な回帰問題に帰着するため、学習はGANに比べて安定しやすく、モード崩壊も起きにくいぶん生成される形状の多様性も高くなる傾向があります。 reverse processの各ステップに目標性能や境界条件を条件として与えるconditional diffusionにすれば、「この性能を満たす形状を生成する」という逆設計(inverse design)にも使えます。 ただし条件への忠実度を上げるguidanceを強くかけるほど、この多様性の高さはトレードオフとして失われていく点には注意が必要です。
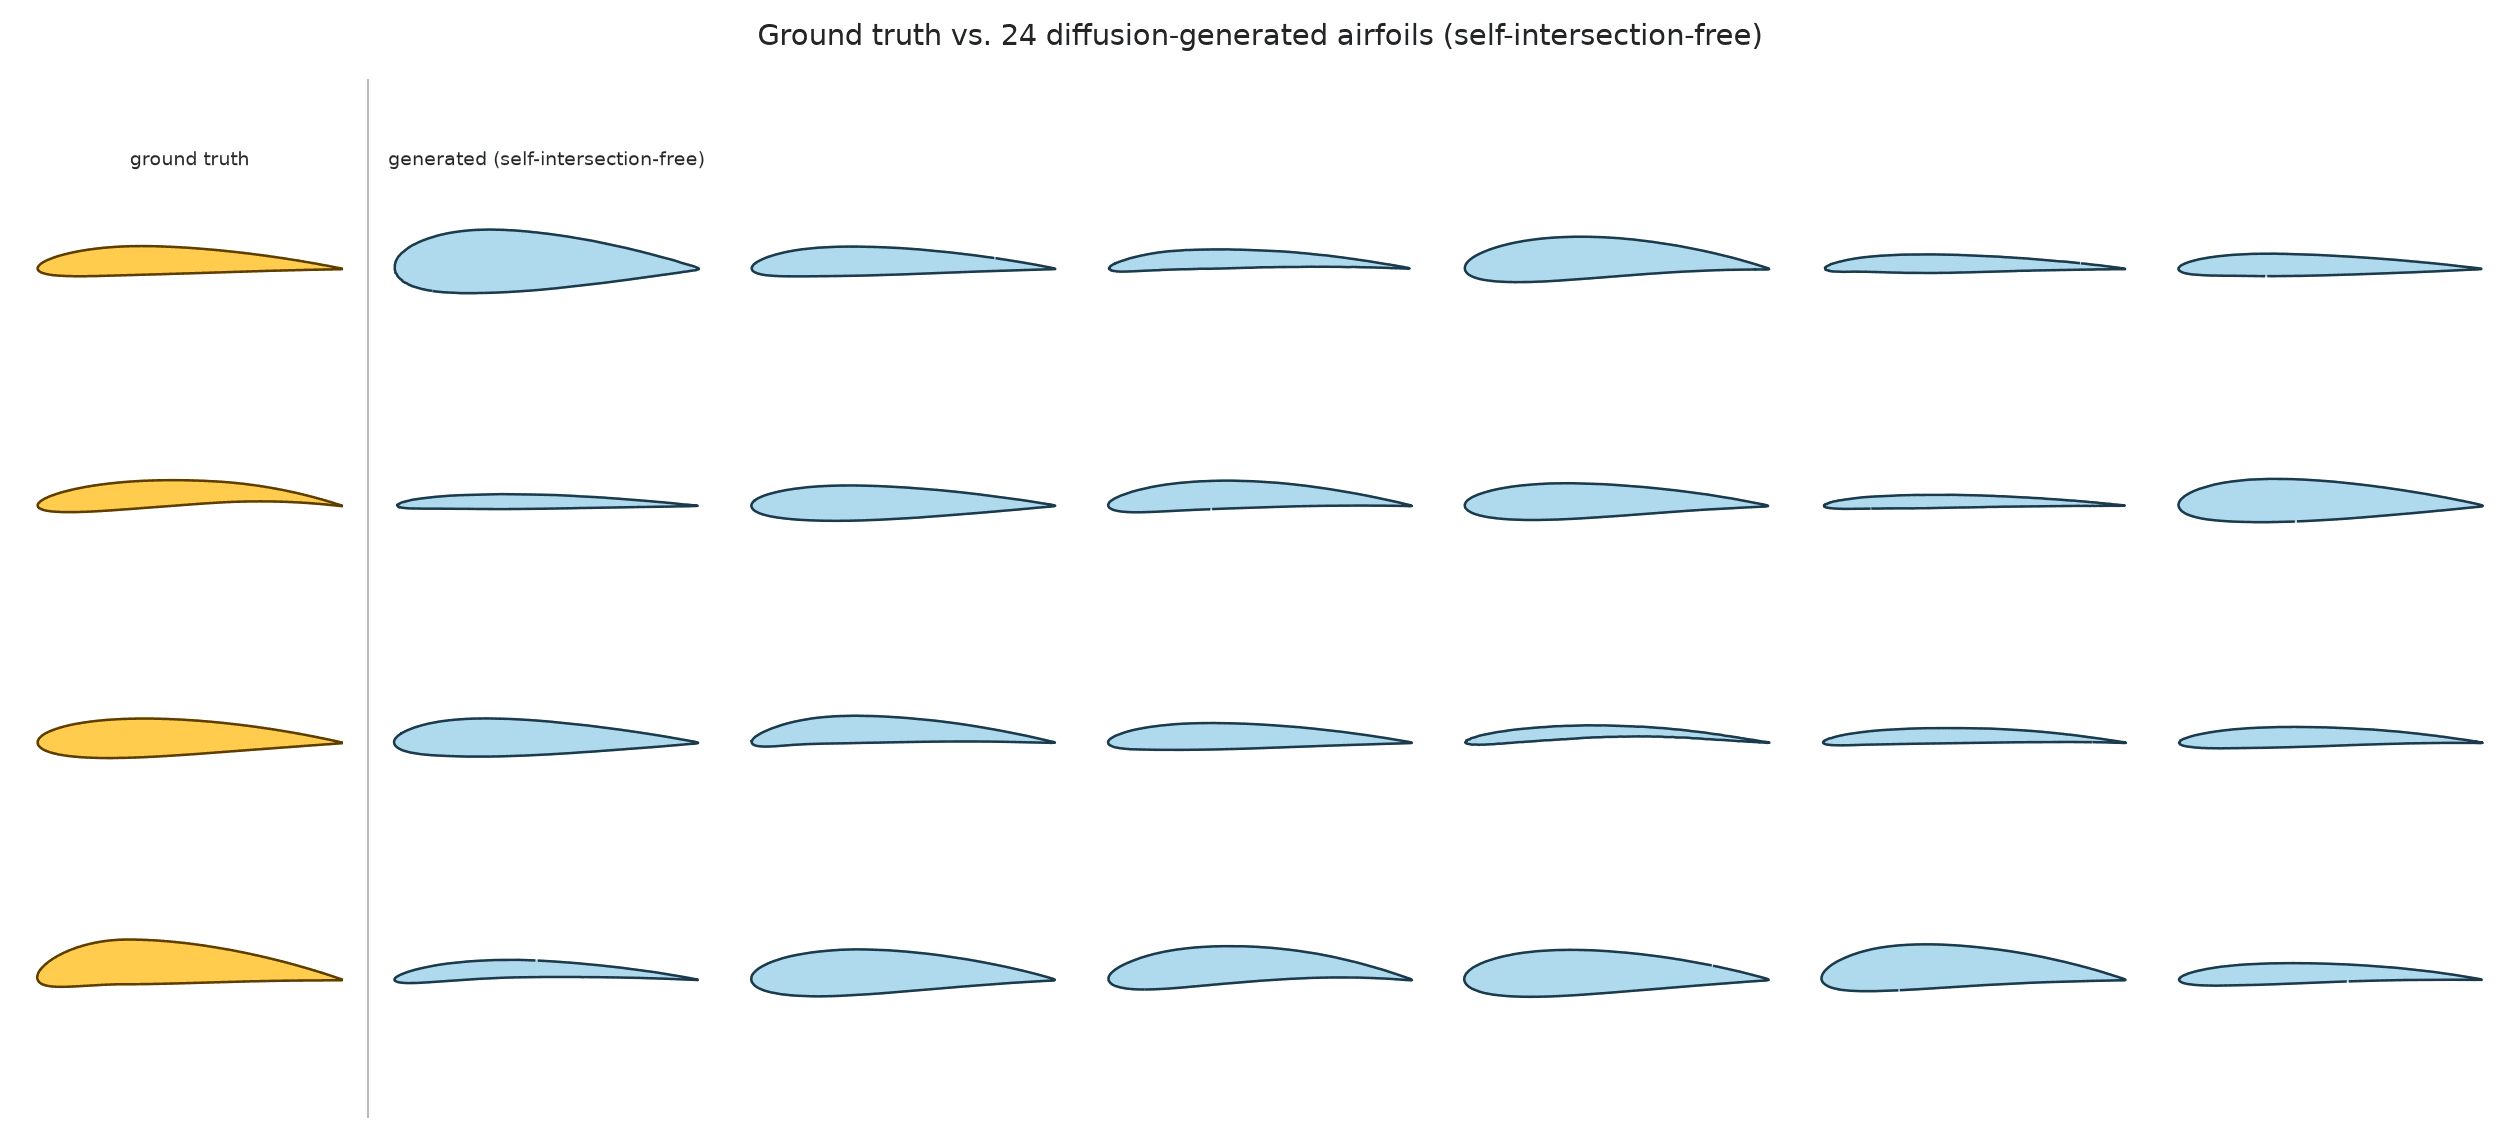
翼型点列データで拡散モデルを学習させ、ノイズから生成した例です。 左端が学習データ(ground truth)、右側が自己交差のない有効な形状のみを残した24個の生成結果です。 前縁の丸みや後縁に向けた薄まり方といった翼型に共通する構造を保ちながら、キャンバーや最大翼厚の位置には学習データにない組み合わせも現れています。 なお、ここでの拡散モデルは形状の点列データそのものにノイズを加えて学習しているため、VAE・GANの とは異なり、ノイズ空間の次元は形状データと同じで、低次元への圧縮は起きていません(先にAutoencoder等で圧縮してから拡散させるlatent diffusionという方式もありますが、ここで扱っているのは素の拡散モデルです)。
弱点は生成コストです。 1つの形状を作るのにreverse processを数十〜数百ステップ繰り返す必要があり、VAEやGANの1回のデコードに比べて明らかに重くなります。 ステップ数を減らす高速化手法も研究されていますが、それでも生成コストの重さは残ります。
最適化にどう組み込むか
ここまでVAE・GAN・拡散モデルを見てきましたが、これらを実際の形状最適化に組み込むには、生成モデルをOptimizerとどう繋ぐかを考える必要があります。 形状最適化のループでは、設計変数を受け取って形状を返す役割(ShapeGenerator)と、その形状を流体解析にかけるSolver、性能を評価するEvaluator、次の設計変数を提案するOptimizerが繰り返し呼び出されます。 生成モデルを使う場合、この設計変数の実体が潜在変数 に置き換わり、ShapeGeneratorの中身は学習済みデコーダの推論呼び出しになるだけで、Solver・Evaluator・Optimizerの役割自体は変わりません。
生成モデルをOptimizerに繋ぐやり方は、大きく3パターンに分かれます。 潜在変数をそのまま設計変数としてOptimizerに渡すパターン、目標性能を条件として生成器に投げ形状候補をまとめて受け取るパターン、そしてこの2つを組み合わせるパターンです。 いずれも「もっともらしい形状の集合」というパラメトリック表現にはなかった前提を手に入れる代わりに、パラメトリック表現とは別種の課題を抱え込みます。
潜在変数を直接最適化変数にする場合
VAEのように潜在空間が滑らかなモデルでは、 をそのままOptimizerの設計変数として渡せます。 ShapeGenerator(学習済みデコーダ)が を形状に変換し、Solver・Evaluatorの評価結果から次の を提案する、通常の最適化ループがそのまま回ります。
diagram rendering…
ここで新たに顔を出すのが、潜在変数の次元数のコントロールという問題です。 パラメトリック表現なら設計変数の数を設計者が自由に絞れますが、潜在空間の次元数は学習時に固定されるハイパーパラメータで、変更するには再学習が必要です。 次元を絞れば連続最適化手法がスケールする範囲に収まりますが、その分だけ表現力が落ちます(CMA-ESは数十〜数百次元まで実用されるのに対し、素朴なガウス過程ベースのベイズ最適化は数十次元を超えると急激に厳しくなるなど、許容できる次元数は手法によって大きく異なります)。 逆に次元を増やせば、今度はOptimizer側が次元の呪いに直面します。 結局のところ「自由度を上げるほど最適化しにくくなる」というパラメトリック表現の頃からの問題は、パラメータ数から潜在空間の次元数に姿を変えて残るわけです。
conditionalな生成器で狙い撃ちする場合
拡散モデルのところで触れたconditional diffusionのように、目標性能を条件に形状を生成させるアプローチは、潜在変数の次元数をOptimizerに直接触らせない分、上の問題を回避できます。 Optimizerが1点ずつ問い合わせるのではなく、事前に学習した生成器へ目標性能を投げて形状候補をまとめて受け取り、Solver・Evaluatorで絞り込むという2段構えのフローになります。
diagram rendering…
ただし、こちらには学習データの課題があります。 conditionalな生成器を学習させるには、形状データだけでなく「その形状が達成した性能値」がペアになった学習データが必要で、既存の形状の多くに対してあらかじめCFDを実行し、目的関数の値を紐付けておかなければなりません。 active learning的に少数ずつ性能値を追加していくやり方も考えられますが、いずれにせよまとまった量のCFD実行を最適化本番の前段階に持ってくる必要があることに変わりはなく、性能値が付随していない既存データから後追いでラベル付けするのは、それ自体が小さな最適化プロジェクトに匹敵する工数になりがちです。
簡易ソルバーとconditionalな生成器を組み合わせる場合
上の2パターンは組み合わせることもできます。 まず簡易ソルバー(低忠実度のCFDや代理モデル)で既存形状の性能値を計算し、それを条件としたconditionalな生成器を学習させて有力な候補まで絞り込みます(ここまでは「conditionalな生成器で狙い撃ちする場合」と同じです)。 そこからさらに、絞り込んだ候補をエンコーダで潜在変数に戻し、本番ソルバー(高忠実度CFD)とOptimizerによる直接最適化で局所的に追い込みます。
diagram rendering…
狙いは、単独では課題だった点を互いに補い合うことです。 conditional生成パターンの弱点だった学習データへの目的関数値の付与は、本番ソルバーの代わりに簡易ソルバーを使うことでコストを抑えられ、直接最適化パターンの弱点だった潜在次元数の決め打ちも、探索対象を絞り込んだ候補の近傍に限定することで次元の呪いの影響を受けにくくなります。
ただし新たな課題もあります。 1つは簡易ソルバーと本番ソルバーの間の忠実度ギャップで、簡易ソルバーで有望と判定された領域が本番ソルバーでは有望でない、というマルチフィデリティ最適化一般の問題がそのまま持ち込まれます。 もう1つは形状から潜在変数へのエンコードの可否で、VAEなら学習済みのエンコーダがそのまま使えますが、GANや拡散モデルにはエンコーダが備わっていないため、GAN inversionやDDIM inversionといった追加の手法が必要になります。
使い分けの軸
まとめると、潜在変数を直接最適化するパターンは「潜在次元数というハイパーパラメータの決め打ち」が、conditional生成パターンは「学習データへの目的関数値の付与(CFD実行とセット)」が、両者を組み合わせるパターンは「忠実度ギャップとエンコードの可否」が、それぞれ課題になります。
生成モデルとの相性で言えば、VAEは潜在空間が滑らかなので次元数さえ折り合いをつければ直接最適化にほぼそのまま使えます。 GANは生成品質は高いものの潜在空間の構造が保証されないため、Optimizerが有効に探索できない領域ができてしまうことがあります。 拡散モデルは、Optimizerが1点ずつ問い合わせて逐次探索する使い方には生成コストが重く、むしろ条件付き生成で目標性能に近い形状候補をまとめて多数サンプリングし、そこからSolver・Evaluatorで絞り込むという使い方のほうが相性が良いはずです。
実務上の壁
生成モデルを最適化に使うには、まず学習データとして十分な量の既存設計データが必要です。 これは学習データがAI Ready、つまり境界条件やメッシュ生成ロジックまで含めて再現可能な形で整備されていることが前提で、寄せ集めのデータでは潜在空間が学習対象のデータセットの癖を強く反映してしまい、欲しい設計空間をカバーできません。
もう1つの壁は、生成された形状の物理的な妥当性です。 潜在空間上のある点をデコードした結果がメッシュとして破綻していたり、明らかに製造不可能だったりすることがあり、これはVAE・GAN・拡散モデルに共通する問題として、生成後にSolverへ渡す前の形状バリデーションや修復処理が別途必要になります。
形状をどう表現するか(ボクセル、SDF、点群、メッシュ)という選択も避けて通れません。 これはCNN・PointNet・GNNといったアーキテクチャの選び方とも表裏一体で、生成モデルのエンコーダ・デコーダ側にも同じ制約がかかってきます。
整理すると
| モデル | 学習の安定性 | 潜在空間の滑らかさ | 生成品質 | 逆設計への向き | 生成コスト |
|---|---|---|---|---|---|
| VAE | 安定 | 滑らか(最適化向き) | ぼやけやすい | △ | 低い(1回のデコード) |
| GAN | 不安定になりやすい | 保証されない | 鮮明 | △〜○(条件付きGAN) | 低い(1回のデコード) |
| 拡散モデル | 比較的安定 | 明示的な保証はないが多様性は高い | 高い | ○(conditional diffusion) | 高い(多段のステップ) |
おわりに
生成モデルは、パラメトリック表現では届かなかった形状の自由度を最適化に持ち込む手段として、設計変数の選択肢を広げてくれます。 ただしVAE・GAN・拡散モデルは得意なことが違い、Optimizerへの組み込み方にも一長一短があるので、「潜在空間を直接探索したいのか」「目標性能から形状を逆生成したいのか」という目的から逆算して選ぶ必要があります。 そして、どのモデル・パターンを選んでも、学習データのAI ReadyさとSolverに渡す前の形状バリデーションという実務上の壁は残ります。 生成モデルは魔法ではなく、既存の設計プロセスや最適化ループに地続きに組み込むものだと捉えるのが実務的だと思います。